フューチャーの脆弱性管理サービス FutureVuls と、OSS の脆弱性スキャナ Vuls が検知に使う脆弱性データベース(以下、DB)に、公開前の検査「diff guard」を入れました。OS のベンダーなど 40 以上のデータソース(以下、上流)から自動で作った DB を、前回公開した DB とくらべ、差分が大きすぎれば公開を止め、人が確かめます。上流のデータが欠けたり壊れたりしても、利用者の検知結果に届く前に気づけます。116 日間の運用で、Windows のひと月分の CVE(公表された脆弱性の番号。最大で約 1,270 件)を検知できなくなる DB を 2 件、私たちの変換コードのバグが入った DB を 1 件、公開の手前で止めました。
この検査と 116 日間の記録を、2026年10月20日、CSS2026(コンピュータセキュリティシンポジウム2026)の OWS(OSSセキュリティ技術ワークショップ)のセッションで、「脆弱性情報の上流は安定していない: 公開前検査による116日間の全数観測」として発表しました。この発表で、OWS研究賞をいただきました。実用性の高さと、OSS コミュニティへの貢献を評価する賞です。選んでくださった OWS 実行委員会のみなさまに感謝します。
検査は 943 回の実行のうち 420 回で止まり、同じデータソースで続いたものをまとめると 69 件でした。原因をすべて調べると、59 件は上流のデータの変化です。上流は平均して 2 日に 1 件のペースで大きく動き、その大半は正当な変更でした。
発表の情報
| 項目 | 内容 |
|---|---|
| イベント | CSS2026(アクトシティ浜松)、OSSセキュリティ技術ワークショップ(OWS)2026 |
| 日付 | 2026年10月20日(火) |
| セッション | 2F1「脆弱性情報・優先度評価」([OWS③]、9:00〜10:40、F会場)の 2 件目(2F1-2、プログラム) |
| 題目 | 「脆弱性情報の上流は安定していない: 公開前検査による116日間の全数観測」 |
| 著者 | 篠原俊一、中岡典弘、神戸康多(フューチャー株式会社) |
| 受賞 | OWS研究賞(2026) |
| 資料 | 論文 PDF、スライド PDF、データ |
出発点:ビルドの成功は、DB の正しさを保証しない
DB は、収集、変換、構築の 3 つの工程で作ります。収集したままのデータ(raw)と、共通の形式に変換したデータは、Git で全履歴を残し、過去に作った DB もすべて残しています。この基盤は、昨年の CSS2025 で発表しました。
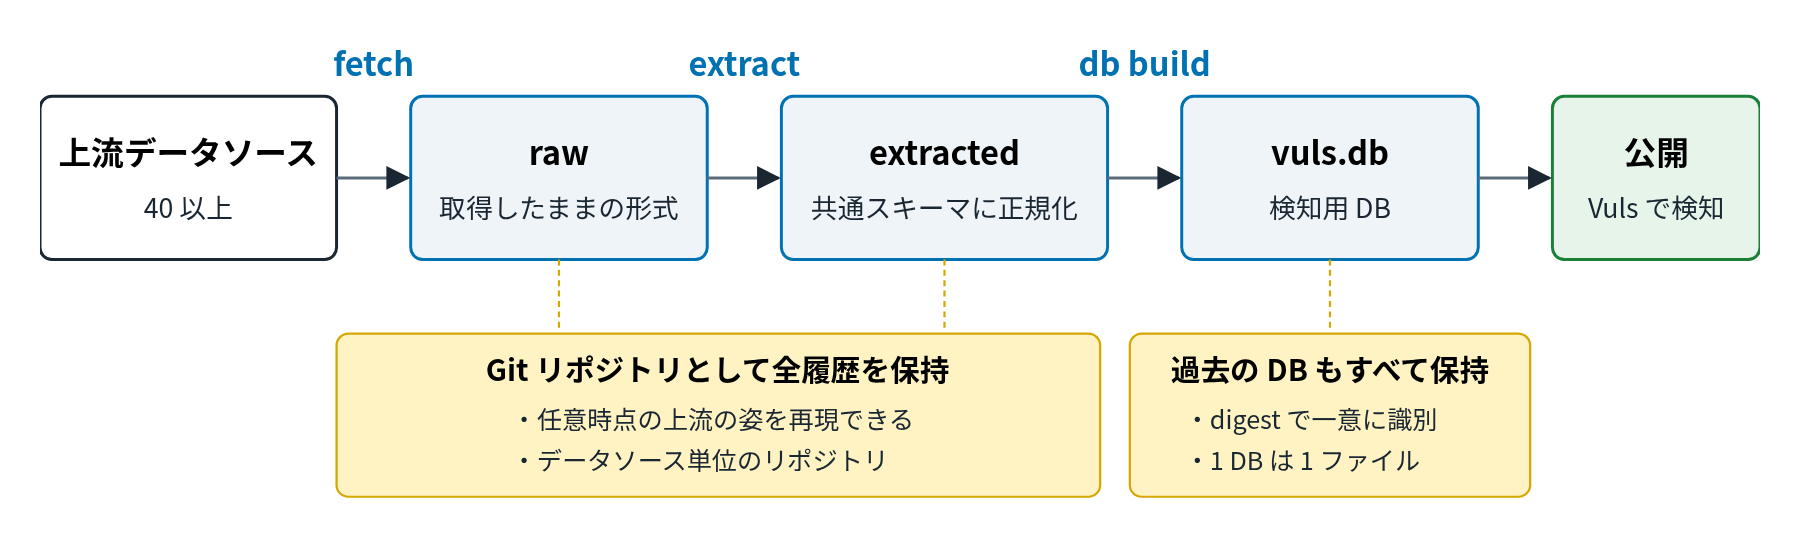
この流れは全自動で、ビルドが成功すれば DB は公開まで進みます。2026年3月、ビルドは成功したのに検知が大きく変わる出来事が 2 つありました。
- 上流のデータの異常が、検知の欠けになった:上流から壊れたデータが届いた日に、私たちの側のデータ形式の変更が重なりました。変換はエラーになってデータは古い形式のまま残り、新しい形式を前提にした後ろの処理が、中身の無いデータを作りました。その結果、Red Hat Enterprise Linux 9 で本来検知される CVE の 51.9%(3,387 件)が、「影響なし」になりました。
- DB と古いスキャナの組み合わせで、検知が増えた:DB に新しく入れた目印の項目を、古いバージョンのスキャナが解釈できず、Ubuntu 22.04 の検知が 5,968 件から 12,296 件(+106.0%)になりました。DB もスキャナも、単体では正常でした。
どちらの場合も、当時の CI(自動でビルドや公開をする仕組み)は、できた DB の中身を確かめていませんでした。上流のデータの異常や、DB とスキャナの食い違いを、利用者の検知結果に届く前に止める仕組みが必要でした。
作ったもの:公開前に前回の DB とくらべる「diff guard」
そこで、DB を公開する直前に、今回ビルドした DB(候補)と、直前に公開した DB(baseline)をくらべる検査を入れました。論文では「公開前検査」、実装では diff guard と呼んでいます。
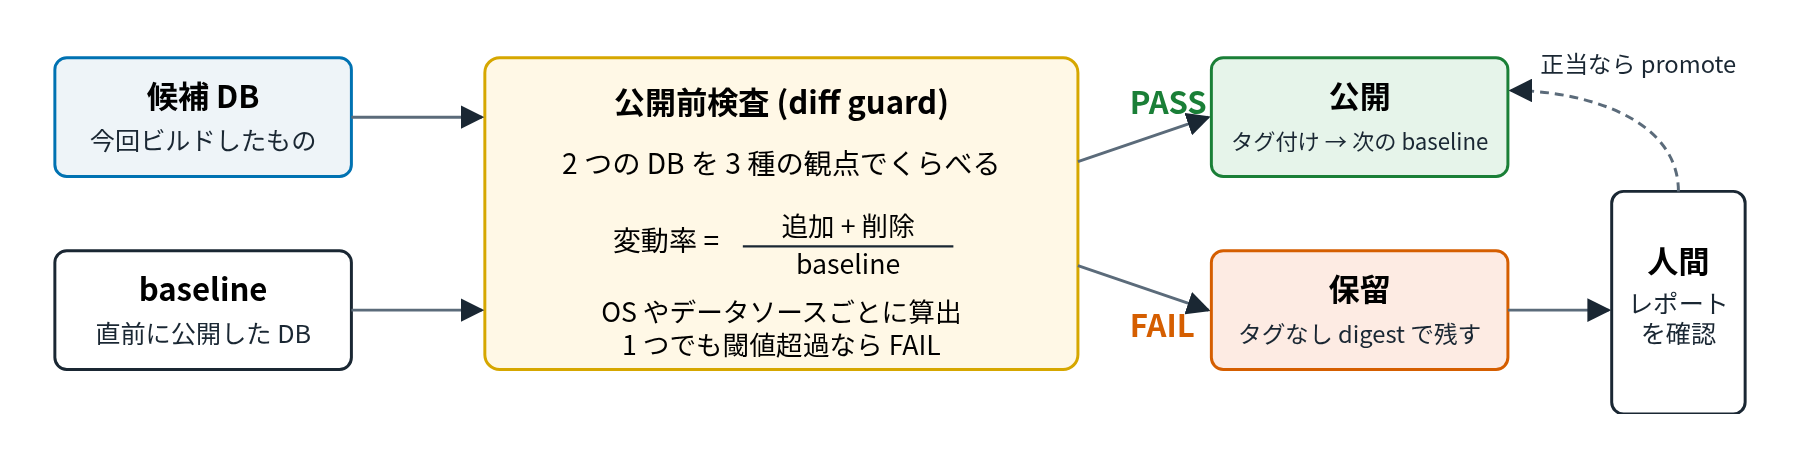
くらべる観点は 3 つあります。
| 観点 | くらべるもの | ねらい |
|---|---|---|
| 検知(新) | 実機から取ったスキャン結果 75 本を、最新のスキャナと 2 つの DB で検知にかけ、出てきた CVE の集合をくらべる | DB の更新で検知が増えたか、減ったか |
| 検知(旧) | 同じことを、バージョンを固定した古いスキャナで行う | 古いスキャナとの非互換(3 月の Ubuntu の型) |
| DB 構造 | 2 つの DB の中の検知条件(約 330 万件)を直接くらべる | スキャン結果 75 本に含まれない対象の変化 |
変動率は、追加と削除の件数の合計を、baseline の件数で割った値です。対象(OS とそのバージョンなど)ごとに計算し、1 つでも閾値を超えたら公開を止めます。止めた DB は捨てずに、公開用の名前(タグ)を付けない状態で残します。人がレポートを読み、正当な変更だと判断したら、その DB を公開に昇格させます。この操作を promote と呼んでいます。
この検査は、変更が正しいか誤りかを判定しません。見ているのは差分の大きさだけです。
閾値は、入れる前に測って決めた
入れる前に、となり合う日の DB 35 組で、DB 構造の変動率を測りました。ふだんの変動は中央値 0.3%、最大でも 6.2% でした。10% を超えたのは 2 組だけで、3 月の Red Hat の件(変動率が最大だった Red Hat Enterprise Linux 6 で 65.1%)と、SUSE のデータの大規模な再発行(16.1%)です。
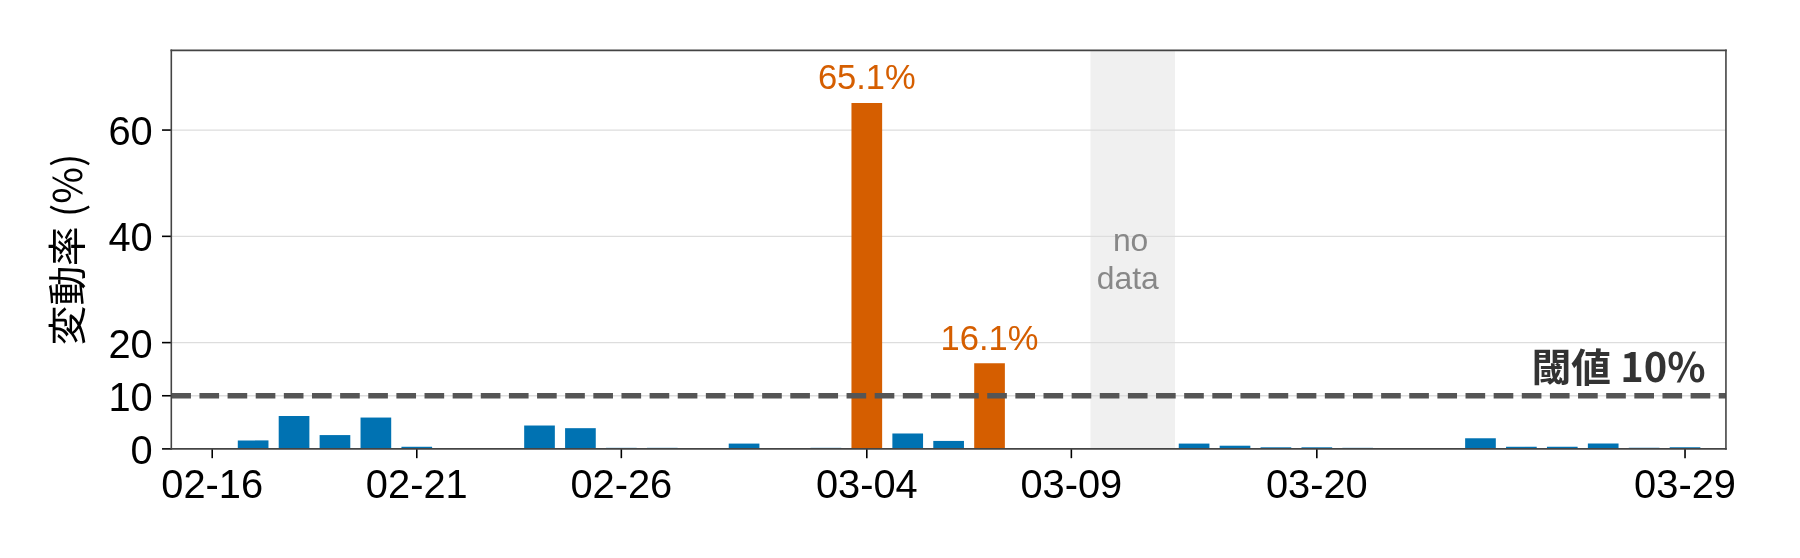
ふだんの変動(中央値 0.3%)と、人が確かめたい出来事(16% 以上)は、桁が違っていました。そこで DB 構造の閾値を 10% にしました。検知の閾値は、経験からそれより厳しい 5% にしています。
現実:翌日から止まった
「2 週に 1 回止まるくらいだろう」と見込んで、2026年4月23日に本番へ入れました。翌日に止まりました。最初の promote(4月27日)まで、20 回連続で止まっています。
観測した 116 日間(2026年4月23日〜8月16日)では、943 回の実行(ビルドから公開まで)のうち、420 回(44.5%)を検査が止めました。promote した DB は 92 個で、1 日あたり 0.79 個です。ほぼ毎朝、まずレポートを読んで promote するのが日課になりました。
止まりすぎです。ただ、止まった理由を調べるうちに、見方が変わりました。止まった記録は、うるさい検査の記録ではなく、上流で何が起きたかを示す地震計として読めます。そこで、116 日間の記録を全部集め、止まった原因を数えました。
116 日間の全件調査:69 件のうち 55 件は、上流の正当な変更
止まった 420 回のうち、差分が閾値を超えたものは 418 回です(残る 2 回は検査の基盤の障害)。止めている間は baseline が変わらないので、同じ差分が実行のたびに繰り返し止まります。同じデータソースで続いた停止をひとまとめにすると、69 件になりました。24 時間以上あいたら別の件と数える規則で、12 時間にすると 77 件、48 時間にすると 62 件です。
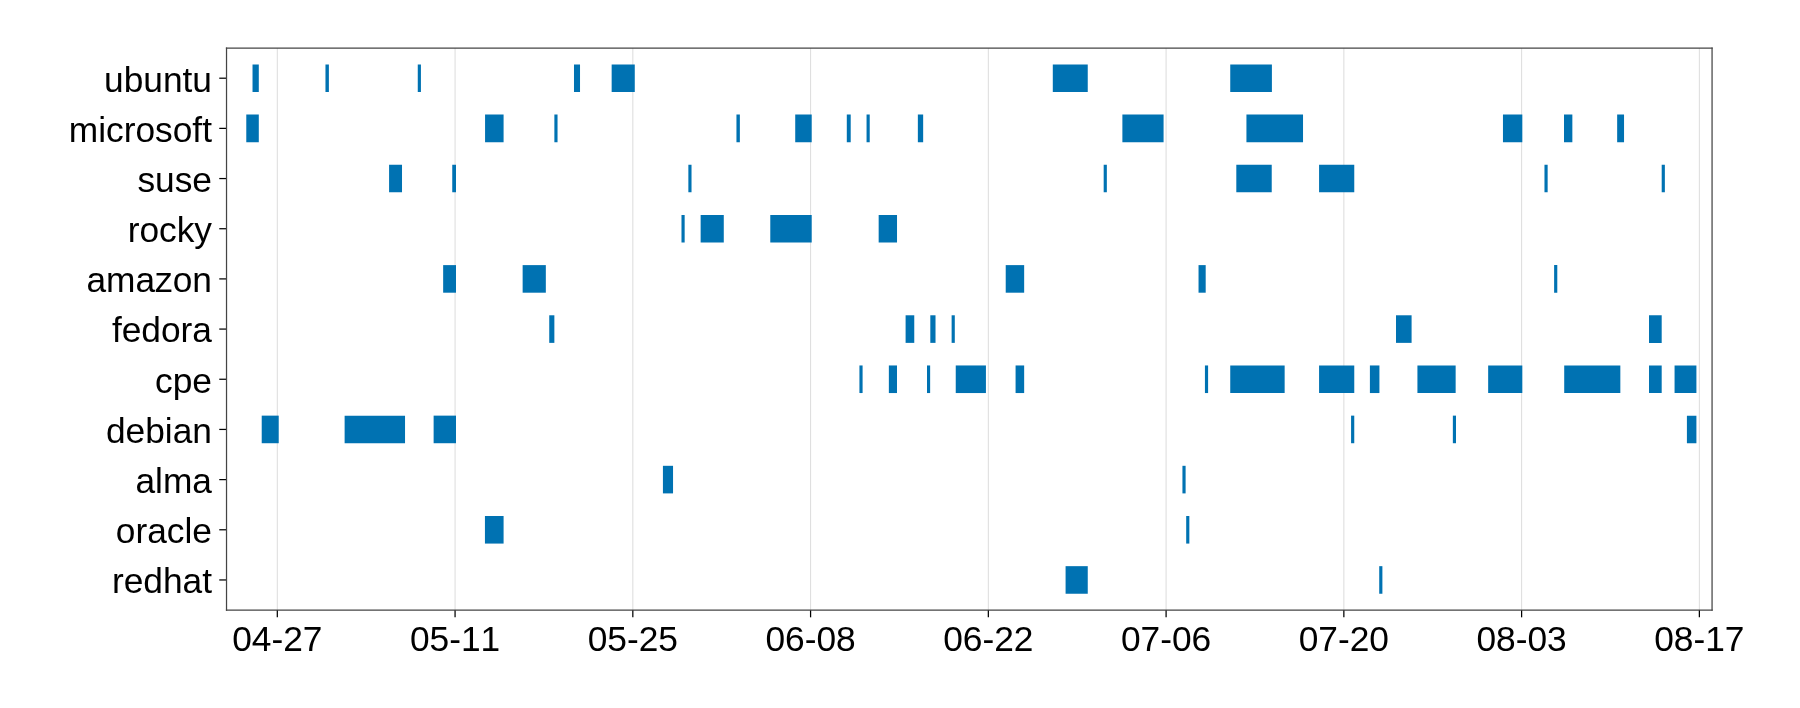
69 件のそれぞれについて、DB から入力の側へさかのぼり、原因の候補を順に消していきました。
- DB 構築:2 つの DB を作ったコードのバージョンが同じか
- 収集と変換:そのデータソースのコードに、期間中の変更があるか
- 収集の設定:取りに行く対象(OS やバージョン)を変えていないか
- 上流:raw の Git 履歴から、件数や ID がレポートと合う変更を探す
全工程の履歴が残っているので、「原因不明」は 0 件でした。私たちの側が原因の 10 件は、原因になった変更まで確かめています。上流が原因の 59 件は、1〜3 に関係する変更が無いことを履歴で確かめ、代表的な件では raw の差分まで確かめました。
| 原因 | 件数 | 例 |
|---|---|---|
| 上流:正当な変更 | 55 | 月例パッチ、新しい OS のリリース |
| 上流:一時的な障害 | 2 | ひと月分の月例データが消えた(Microsoft) |
| 上流:ずっと続く品質の変化 | 2 | 修正情報の作り直し(AlmaLinux) |
| 自分たち:意図した変更 | 9 | 検知条件の変換、取りに行く対象の追加 |
| 自分たち:変換コードのバグ | 1 | 出力の順番が実行のたびに変わる |
上流が原因の 59 件は、116 日で割ると 2 日に 1 件です。正当な変更でも大きく動き、Oracle Linux では、1 つの advisory(セキュリティ情報)に CVE が 822 件載った日がありました。
なお、この調査の大半は AI エージェントに任せています。上の 4 段の手順を手順書にしてあり、エージェントは履歴を調べて、原因がどの工程にあり、根拠がどの差分かを報告します。promote するかどうかの判断と実行は人間だけが行い、エージェントには公開の操作をする権限を渡していません。
上流はこう動く:3 つの実例
消えて、戻って、また消える:Microsoft の月例データ
2026年6月16日、Microsoft が配信するセキュリティ更新の文書(CVRF)の 6 月分が、raw から丸ごと消えました。API は HTTP 200 を返し、収集も変換も成功しています。できた DB では、6 月分の Windows の CVE を検知できなくなっていました。13 時間後の収集でデータは戻りましたが、7月2日と 3日にも、消えては戻ることを繰り返しました。
| 収集した日時(UTC) | 変更された行数 | 2026年6月分のファイル数 |
|---|---|---|
| 06-15 16:57 | 723 | |
| 06-16 03:02 | −251,429 | 0 |
| 06-16 16:33 | +248,779 | 811 |
| (中略) | ||
| 07-01 14:17 | 1,273 | |
| 07-02 02:01 | −327,295 | 0 |
| 07-02 13:26 | +335,383 | 1,273 |
| 07-03 01:42 | −327,838 | 0 |
| 07-03 13:33 | +338,693 | 1,278 |
3 回の消失のどれでも、検知(新)の観点が、Windows のスキャン結果 13 本すべてで「減るだけ」の動きを捕まえました。このとき DB 構造の観点は止まりませんでした。当時この観点は、Windows については更新プログラムの集合しか見ておらず、そこに付く CVE が消えても、変動率は 0% だったためです。なお、7 月の 2 回は続けて起きたので、件数としては 6 月と 7 月の 2 件と数えています。
仕様どおりに、過去の情報が減る:AlmaLinux の errata
2026年5月27日、AlmaLinux 10 の errata(修正情報)が一斉に減りました。advisory は 279 件から一時 60 件まで減り、何度かの作り直しを経て 136 件になりました。残った advisory も中身が減っています。kernel の ALSA-2026:2721 では、対象のパッケージが 75 種から 2 種になりました。errata の全体から消えた CVE は 376 件です。
$ git show --stat e64c5ca88 -- 10/ALSA/2026/ALSA-2026:2721.json
 10/ALSA/2026/ALSA-2026:2721.json | 2412 +-----------------------------------------
 1 file changed, 6 insertions(+), 2406 deletions(-)
上流に問い合わせると、仕様どおりという回答でした(AlmaLinux Bug Tracker #644)。errata に載るのは、最新のリリースにあるパッケージだけです。前日に AlmaLinux 10.2 が出て、10.1 向けの分が消えていました。上流にとっては正しい動きです。けれども、10.1 のサーバをスキャンする側から見ると、検知に必要な情報が消えたことになります。私たちは、消えた advisory を raw の履歴から復元して取り込むようにしました。
増えたように見えて、検知が減る:VulnCheck の一斉更新
2026年7月8日、VulnCheck のデータで、1 回の更新で 145,672 ファイルが書き換わりました。全年代の CVE に、CPE(ソフトウェア製品を表す共通の名前)の条件が一斉に付いたためです。DB 構造の観点が 28.9% で止めました。当時、この DB の CPE を使った検知は開発中でした。私たちは「開発中の部分で、情報が増えただけだろう」と見て promote しました。
実際には、CPE の書き方も変わっていました。次の例では、製品の種類を表す部分が a(アプリケーション)から o(OS)に変わっています。書き方が変わると、これまでの CPE を指定したスキャン結果とは一致しなくなります。
例: CVE-2012-5010(Cisco ASA)の CPE 条件
  07-08 より前   cpe:2.3:a:cisco:adaptive_security_appliance_software:-:*:*:*:*:*:*:*
  07-08 以降     cpe:2.3:o:cisco:adaptive_security_appliance_software:*:*:*:*:*:*:*:*
後からデータソース単位で測り直すと、VulnCheck 単体の変動率は 189.6% でした。当時は CPE 系の 7 つのデータソースをまとめて測っていたので、NVD(米国の脆弱性データベース)の件数の大きさに埋もれて、28.9% に薄まっていました。更新の前後の DB を、CPE を指定したスキャン結果 3 本でくらべると、2 本で、検知される CVE が 64〜75% 減っていました(67 件から 24 件、69 件から 17 件)。
止めた 3 件と、止めきれなかった 2 件
116 日間で、検査が止めて、公開せずに済んだ DB は 3 件です。
- Microsoft の 6 月分の消失(2 件:6 月と 7 月):Windows の 6 月分の CVE を検知できない DB を公開せず、上流のデータが戻ってからビルドし直しました。
- 私たちの変換コードのバグ(1 件):Fedora で DB 構造が 274.5% 動いて止まりました。入力の raw は 266 ファイルしか変わっていないのに、変換後のデータは 23,163 ファイルが変わっていました。型の取り違えで並べ替えが実行されず、出力の順番が実行のたびに変わるバグです。コンパイルもテストも通っていて、出力の差分で初めて見つかりました。検知の結果は変わりませんが、実行のたびに大きな差分が出て、本当の変化を見分ける邪魔になります。
一方で、検査が止めたのに、防ぎきれなかったものが 2 件あります。
- AlmaLinux:errata が減ったことで検査が何回も止まり続け、その停止を解消しようと promote して、減った DB を数時間公開しました。同じ日のうちに、減る前のデータに戻しています。
- VulnCheck:前の節に書いたとおり、薄まった数字を見て promote しました。CPE を使った検知は当時開発中だったため、本番環境への影響はありませんでした。
止めたものを、人が通しました。検査が保証するのは自動で止めるところまでで、その先は、レポートの見せ方と人の判断の問題です。VulnCheck の件を受けて、2026年7月14日に、変動率をデータソースごとに測るように変えました。
会場での質問:「正しさ」はどう判断するのか
質疑では、「その変更が正しいかどうかは、どう判断するのか」という質問をいただきました。
私の答えはこうです。変更には「絶対に正しい」と「絶対にまずい」という両極端があり、その間にスペクトルがあります。その間を完全に自動で判断できるなら、すごいことです。いまは、最後を人間の判断に頼っています。
この記事の実例で言えば、月例パッチで CVE が増えるのは一方の端で、ひと月分のデータが丸ごと消えるのはもう一方の端です。難しいのは、5 月の AlmaLinux の errata のような、その間の変更です。
正しい変更と正しくない変更が、同時に入ることもあります。発表の 1 週間前の 2026年10月12日、AlmaLinux の errata で、366 件の advisory から、x86_64_v2(古い CPU 向けに AlmaLinux 10 が用意しているビルド)の記述が、一部またはすべて抜けました。パッケージそのものは配布元に残っていて、抜けたのは errata の記述だけです。同じ更新には、新しい検知条件 83 件の追加も入っていて、x86_64 のスキャン結果では検知される CVE が 2 件増えていました。止めれば正しい追加も止まり、通せば抜けも通ります。検査は DB 構造の観点で止めました。私たちは、x86_64_v2 の検知が欠けることと、止め続けて新しい CVE が届かないことをくらべ、promote しました。翌日の errata で記述は戻りましたが、それまでの間、x86_64_v2 のサーバでは一部の検知が欠けていたことになります。
VulnCheck の一斉更新も同じで、変動率という 1 つの数字では、情報の追加と検知の減少を区別できません。
FutureVuls の検知にとって、この検査が意味すること
FutureVuls は、この DB を使ってサーバやソフトウェアの脆弱性を検知しています。スキャナの検知は、元になるデータより正確にはなりません。この記事で書いた検査と運用は、次の形で FutureVuls の検知を支えています。
- 大きな差分は、公開の前に人が確かめます。上流のデータが一時的に大きく欠けても、その DB は公開の手前で止まります。Microsoft の件では、止めていなければ、Windows の 6 月分の CVE が検知結果から消えるところでした。
- 上流が消した過去の情報を、履歴から補っています。AlmaLinux の errata から消えた advisory は raw の履歴から復元していて、AlmaLinux 10.1 のままのサーバでも、その分を検知できます。
- 検査の実装、閾値、止まった記録を公開しています。止めきれなかった 2 件も、同じ場所に記録しています。
限界と、論文のあとに進めたこと
この結果には条件があります。
- Vuls の DB という 1 つの系での記録です。閾値や止まる頻度は、他の脆弱性 DB にそのまま当てはまりません。
- 数えたのは、閾値を超えた変更だけです。閾値より小さい変更で壊れた DB を公開していても、この記録には出てきません。利用者からの報告と事後の調査の範囲では、そうした例は確認していません。
- 観測の途中でも検査を改良しています。同じ測定器で測り続けた記録ではありません。
- 検査は、収集の段階の壊れ方をすべては捕まえられません。観測が終わった 4 日後、Fortinet の収集処理が、アクセス確認の画面を「advisory がすべて取り下げられた」と取り違え、raw に残っていた 181 件をすべて削除しました。検査は止まらず、次の実行の失敗で初めて気づきました。この件のあと、空になったデータは収集の段階で記録しないようにしています。
止めることにもコストがあります。止めている間は前回の DB が公開されたままなので、新しい CVE の反映が遅れます。検査が続けて止まっていた期間は、中央値で 11 時間、9 割が 48 時間以内でした。
論文を出したあとに進めたことと、残っている課題です。
- 増える方向と減る方向で、閾値を分けました。検知が減ることは見逃しにつながるので、減る方向を厳しくしています(vuls2 #449)。これで、止まる頻度が減りました。
- 止まったデータソースだけを据え置き、残りは公開する仕組みを実装しています(2026年11月時点)。現状では、1 つのデータソースが閾値を超えると、DB 全体の公開が止まります。そこで、閾値を超えたデータソースの分だけ前回公開した時点のデータに戻して公開します。
- 人の判断の設計は、まだできていません。減る方向の大きな変更は複数人で承認する、承認の前に確かめる項目を決めておく、といった案はありますが、これからです。
まとめ
- 脆弱性情報の上流は、2 日に 1 件のペースで大きく動きます。その大半は正当な変更です。
- それでも、ひと月分の CVE が丸ごと消えるような DB が、ビルドは成功したまま出来上がることがあります。
- FutureVuls と Vuls が使う DB では、公開の前に前回の DB とくらべ、大きな差分を止めています。116 日間で、問題のある DB を 3 件止めました。止めたのに人が通したものも 2 件あります。
公開している資料
- 論文、スライド、データ(実行の一覧、69 件の判定表、集計スクリプト):vulsio/css2026-diff-guard
- 検査の実装:MaineK00n/vuls2
- 閾値の設定と、公開の workflow:vulsio/vuls-data-db
- 昨年の発表(全工程の履歴を残す基盤):vulsio/css2025-vuls2
脆弱性情報を集めて配っている方や、上流としてデータを出している方からの指摘を歓迎します。数え方や判定に疑問があれば、css2026-diff-guard の issue でお知らせください。FutureVuls の検知やデータソースについてのご質問は、お問い合わせフォームからお寄せください。
CSS2026 と OWS 2026 では、フューチャーからほかにも発表しています。同じセッションの 1 件目では、中岡典弘が、検知条件の元にするデータソースを検知の精度でくらべた「脆弱性検知条件の供給源の再検討」を発表し、最優秀論文賞に選ばれました(プログラム)。